STORM Retrieval
데이터 구조화와 청킹 기술의 진화
완결성 높은 자체 RAG 파이프라인으로 성능과 품질을 극대화했으며,
사용자 피드백을 통해 비전문가도 직접 모델을 고도화할 수 있습니다.
KEY POINT
자동 고도화 RAG
피드백을 활용한 Fine-tuning 자동화로, 사용자 응답 평가만으로도 검색 품질을 지속적으로 높일 수 있습니다.
대용량 문서에 최적화된 검색 구조
다단계 검색 필터링 방식으로 대용량 문서를 효율적으로 탐색하고, 복잡한 정보 속에서도 원하는 답을 빠르게 제공합니다.
하이브리드 검색으로 정확도 향상
Lexical 검색으로 단어 일치 기반의 정확도를, Semantic 검색으로 의미 기반 유사도를 모두 확보하여 정확한 결과를 제공합니다.
RAG PERFORMANCE
기술 스택별 엔진 고도화와 고효율 벡터 서치 로직 설계를 기반으로 RAG 성능 및 품질을 비약적으로 향상시켰습니다
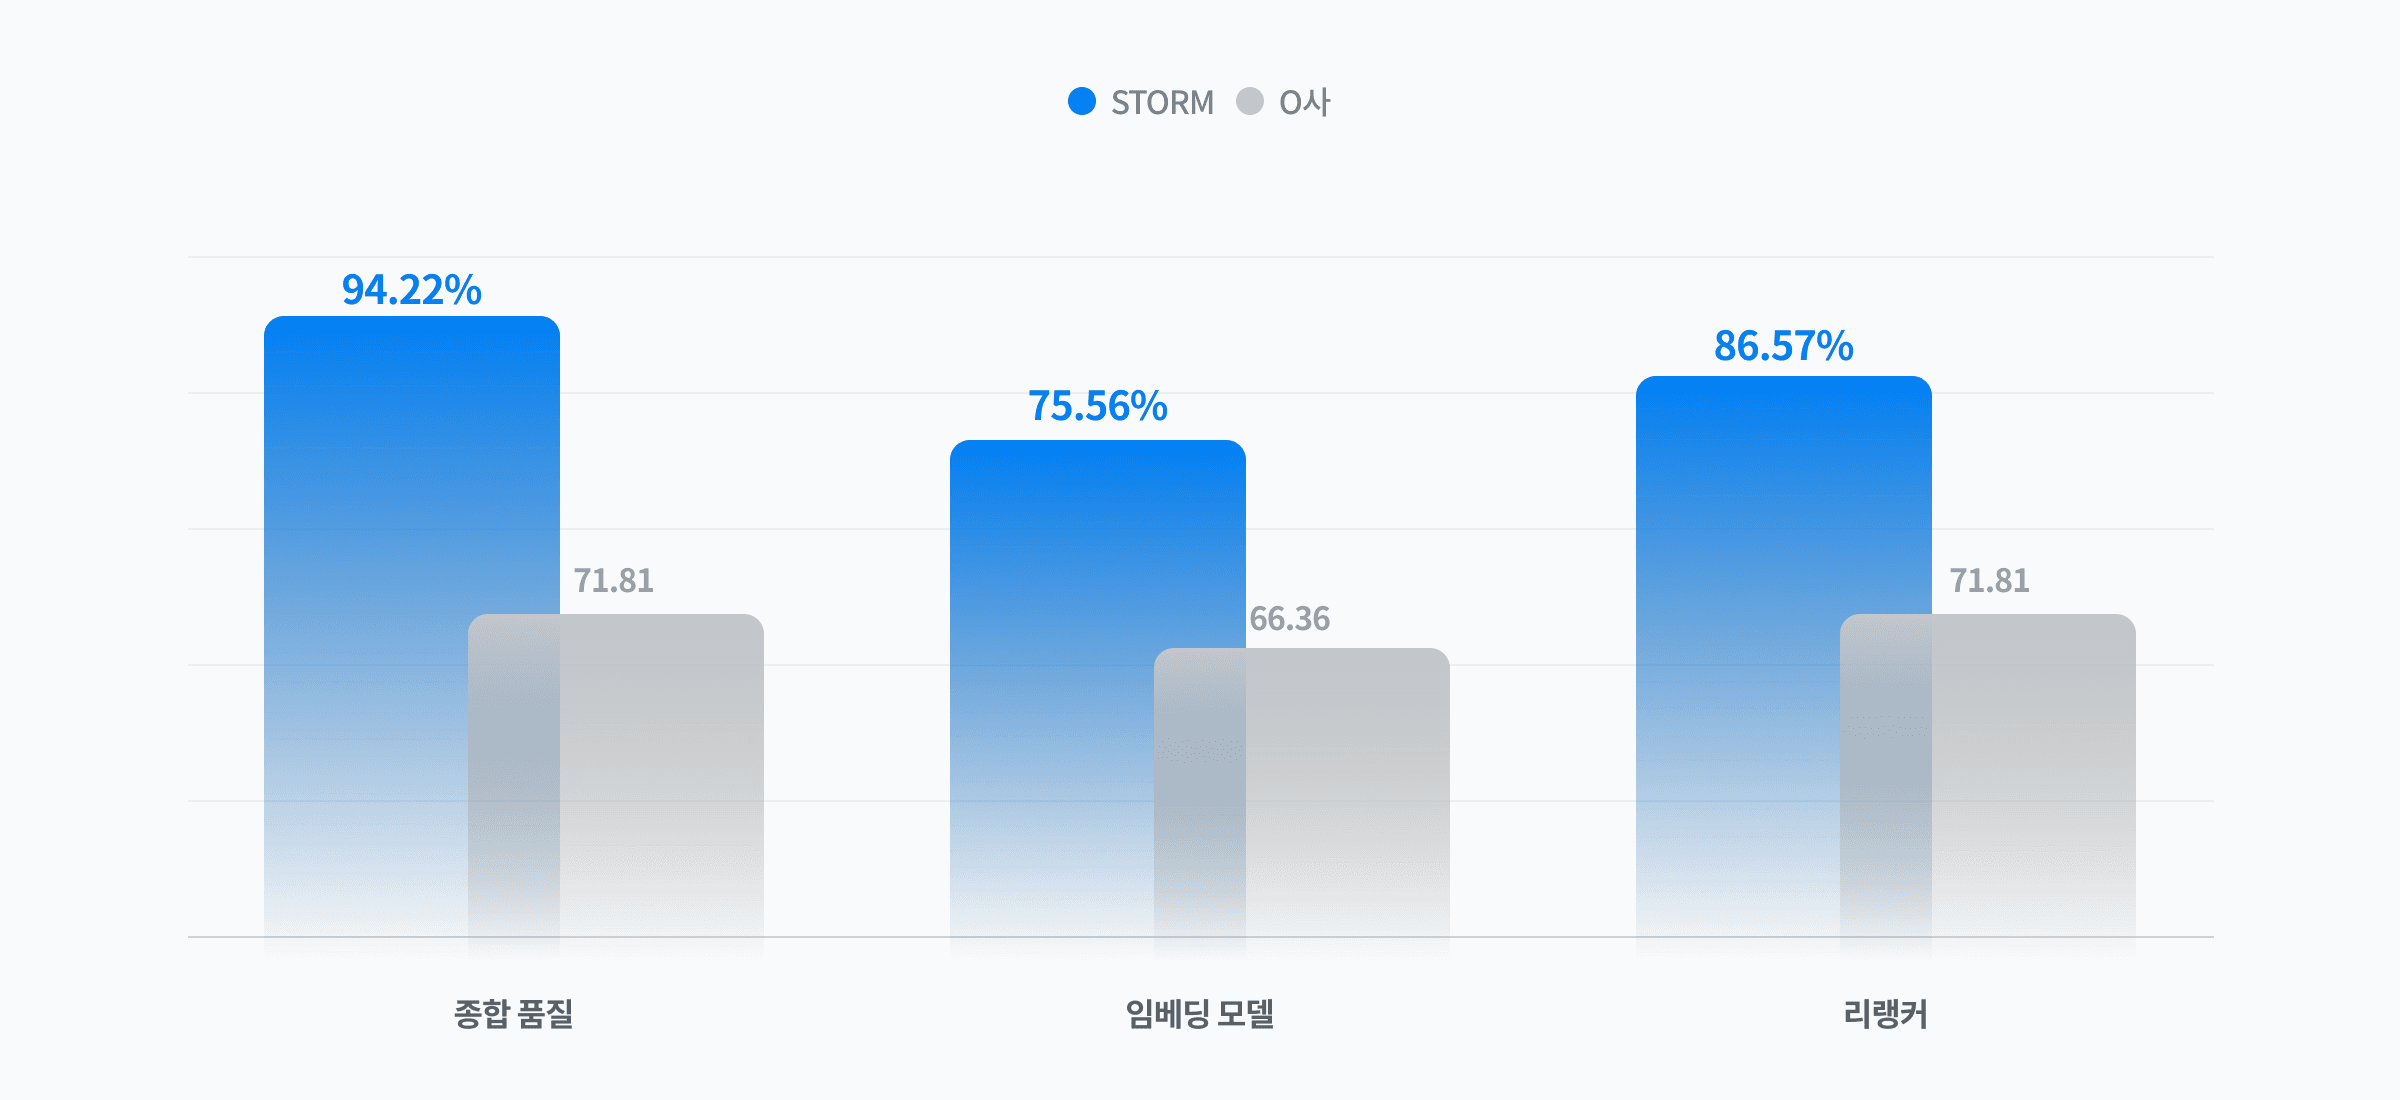
1) <O사 임베딩 모델+리랭커>와 <STORM 임베딩 모델+리랭커+검색 로직> 검색 품질을 Recall@K로 비교
2) <O사 임베딩 모델>과 <STORM 임베딩 모델> 검색 품질을 Recall@K로 비교
3) O사 임베딩 모델로 청크를 찾은 뒤, <O사 리랭커>와 <STORM 리랭커> 검색 품질을 Recall@K로 비교
CORE TECHNOLOGY
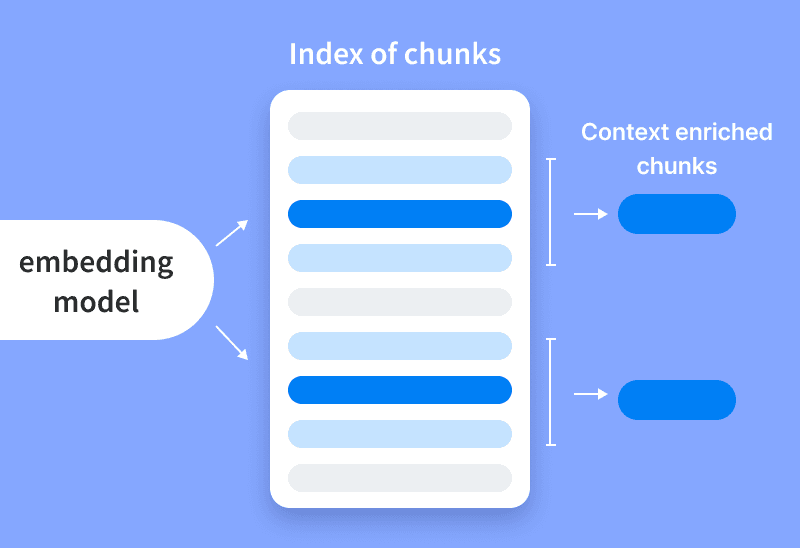
최적화된 청킹 전략
전체 문서 맥락 유지 및 다중 크기 청크 활용으로 컨텍스트를 강화합니다.
- Late Chunking: 문맥을 고려한 청킹
- Multi-scale Chunking: 복수의 청킹 레시피를 적용해, 다양한 문서 유형 및 질의에 최적화
- Contextual Chunking: 청크별 문맥 정보 추가
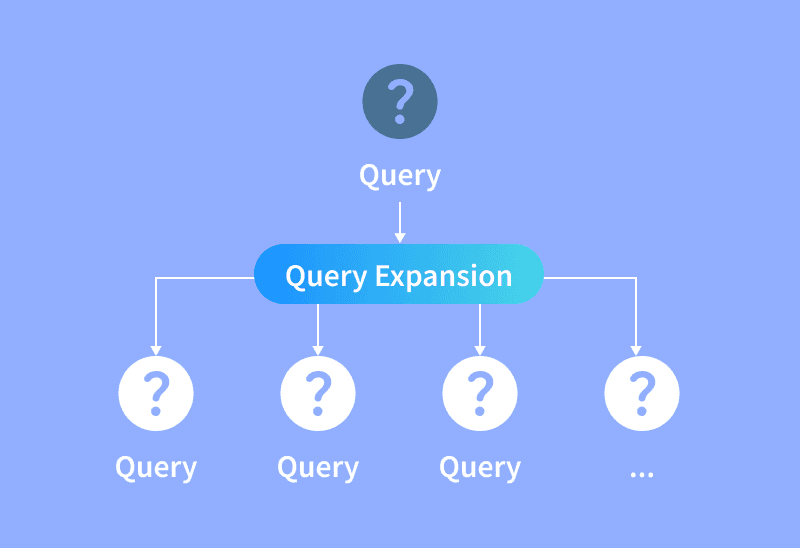
쿼리 익스펜션
사용자의 질의에 내포된 의미를 파악하여, 동의어나 관련어를 활용한 풍부한 쿼리로 확장함으로써 검색의 정확도와 포괄성을 높입니다.
- 질문에 포함된 다양한 단서를 분석해, 다중 탐색 경로로 탐색
- 동의어 및 의미적으로 연관된 표현의 자동 확장
- 이전 문맥을 고려한 쿼리의 의도 기반 재구성
- ‘작년’, ‘어제’ 등의 시간 표현에 대한 문맥 기반 해석 및 반영
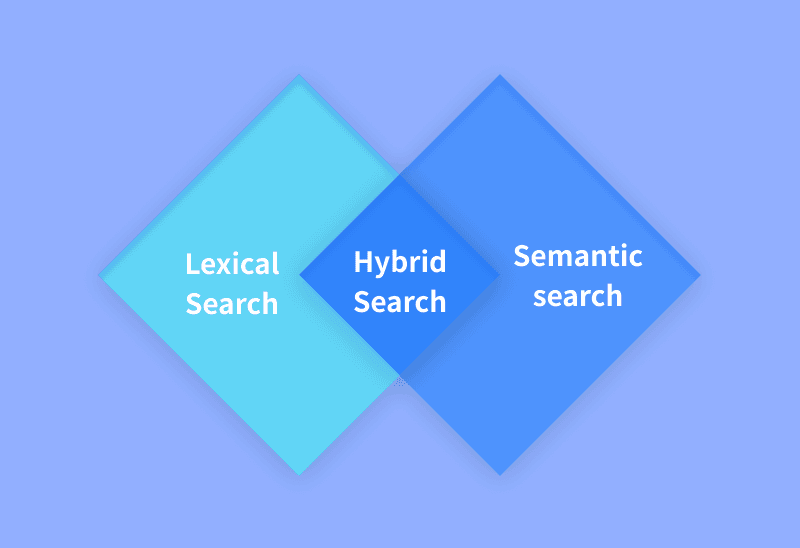
하이브리드 서치
Lexical + Semantic 탐색으로 검색 정확도를 극대화합니다.
- 키워드 기반 정확 매칭(Lexical)
- 의미 기반 유사도 검색(Semantic)
- 하이브리드 결과 통합 및 최적화
후처리
Multi-Reranking과 Chunk Clustering으로 결과를 최적화합니다.
- 유사도 기반 결과 재정렬
- 관련 청크를 묶어 맥락을 보강함으로써 llm 답변 품질 향상
- 중복 제거 및 인접 정보를 통합함으로써, 더 정제된 정보를 기반으로 llm의 고품질 응답 생성 지원